Erfahrungsbericht · Eingebettete Systeme
Zwanzig Panels auf zwanzig Kilobyte
Adaptive Abtastung, Quellenfusion und Speicherdisziplin auf einem ESP32 — was gemessen wurde, und was dabei schiefging.
Inhalt
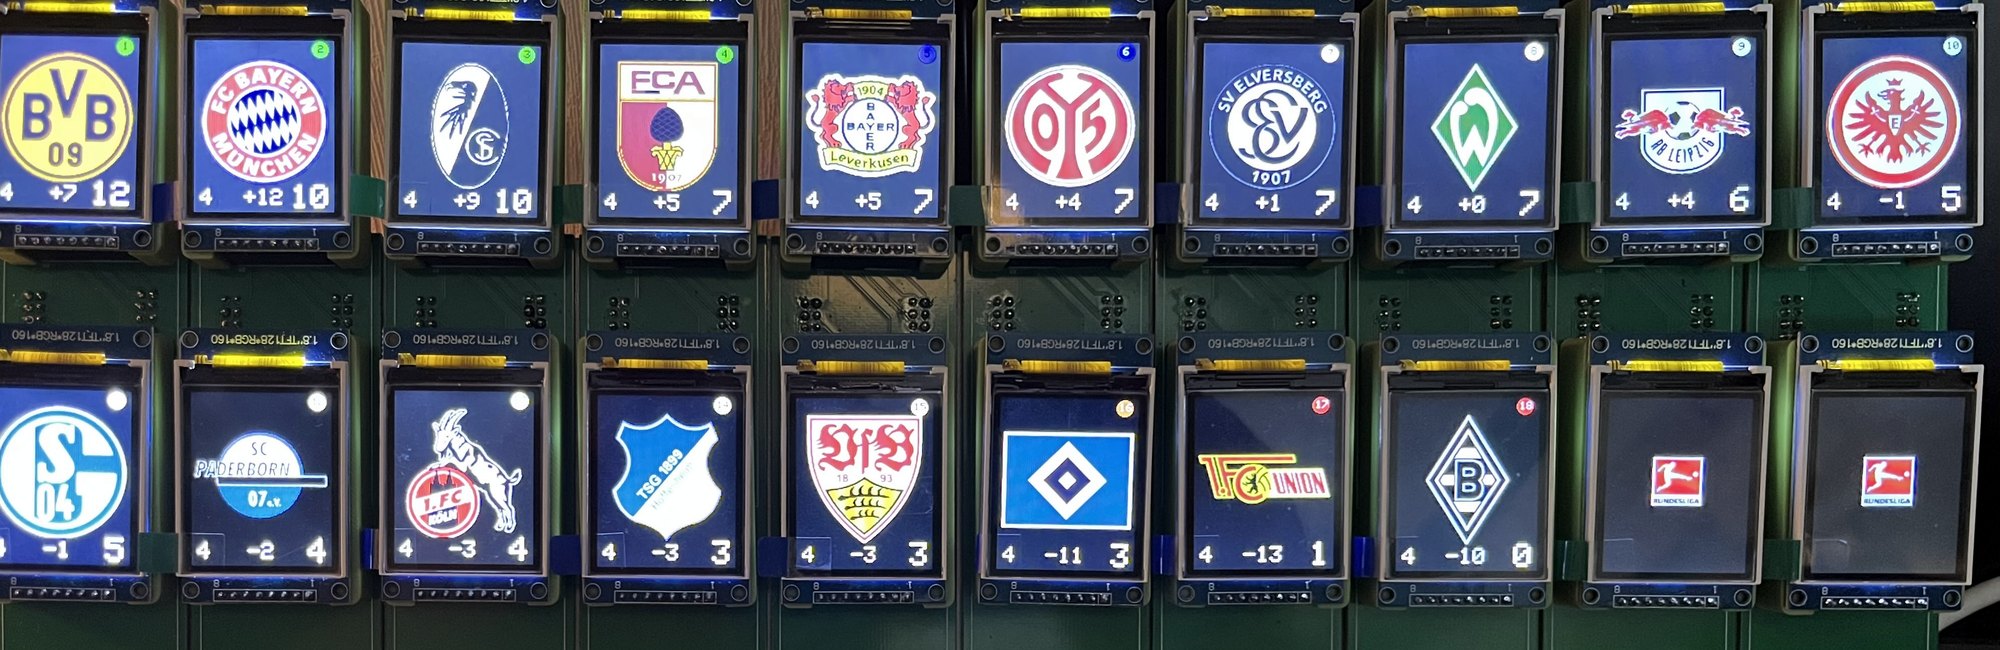
Dieser Bericht beschreibt ein vernetztes Anzeigegerät, das laufende Fußballpartien auf zwanzig kleinen Displays darstellt: zwanzig ST7735-Panels an einer Kette aus Schieberegistern, getrieben von einem ESP32 mit rund 20 kB freiem Heap. Die Datenquellen liefern JSON-Dokumente, die um ein Vielfaches größer sind als der verfügbare Arbeitsspeicher.
Aus dieser Spannung folgen drei Entwurfsentscheidungen, die den Kern des Berichts bilden: ein elementweise arbeitender Parser, der nie mehr als ein Arrayelement zugleich im Speicher hält — in einer einzigen, geteilten 8-kB-Ablage —, eine adaptive Abtastrate von einer Stunde bis zu zwanzig Sekunden je nach Ereigniswahrscheinlichkeit, und eine Quellenfusion, die nicht je Wettbewerb, sondern je Aspekt entscheidet, welcher Quelle sie glaubt.
Berichtet werden gemessene Zahlen aus dem Betrieb und die Fehlschläge, die dorthin geführt haben — darunter eine Vergrößerung eines Puffers um 1 kB, die das Gerät vollständig lahmlegte, und Speichereinbrüche, die monatelang der Anwendung zugeschrieben wurden und vom WLAN-Treiber stammten.
Abschnitt 01Worum es geht
Die meisten IoT-Knoten messen etwas und schicken es fort. Dieser hier macht das Gegenteil: Er holt Zustände aus der Welt und macht sie sichtbar. Er hat keinen Sensor, sondern zwanzig Aktoren, und seine einzige Eingabe ist eine Infrarot-Fernbedienung.
Der Gegenstand ist die Partie — ein einzelnes Spiel zwischen zwei Mannschaften. Von ihr will das Gerät wissen, ob sie läuft, wie sie steht und wer getroffen hat. Ein Spieltag ist die Menge der Partien, die in derselben Runde eines Wettbewerbs stattfinden; sie laufen oft gleichzeitig, und das ist der Fall, der das Gerät an seine Grenzen bringt.
Das klingt nach einer Anzeige, ist aber keine. Eine Anzeige reicht Daten durch. Dieses Gerät muss entscheiden:
- Wie oft es hinsieht. Dauerhaft alle zwanzig Sekunden abzufragen wäre weder den Servern noch dem eigenen Speicher zuzumuten.
- Welcher Quelle es glaubt. Es gibt zwei, sie widersprechen sich, und keine ist überall besser.
- Was überhaupt passiert ist. Keine der Quellen hat ein Feld „das Spiel läuft gerade“. Der Zustand muss abgeleitet werden.
Genau diese drei Fragen machen aus dem Gerät einen interessanten Fall — und sie sind nicht fußballspezifisch. Wer Zustände aus fremden Systemen auf einem eingeschränkten Gerät abbildet, steht vor denselben drei Fragen.
Abschnitt 02Aufbau
Das Gerät ist ein ESP32 mit einem einzigen SPI-Bus für alle zwanzig Panels. Die Chip-Select-Leitungen erzeugt eine Kette aus zehn Schieberegistern (74HC595) — zwanzig einzelne Leitungen wären am Controller nicht unterzubringen. Ein Nebeneffekt dieser Bauweise: Ein Bitfehler in der Kette verschiebt alle nachfolgenden Auswahlen, weshalb die Kette turnusmäßig neu beschrieben wird, auch wenn sich nichts geändert hat.
Das Gateway ist der eigentlich interessante Teil der Architektur. Es leistet dreierlei:
- Schemaübersetzung. Die zweite Quelle liefert eine völlig andere Datenstruktur. Ein schlanker Dienst übersetzt sie in die Form der ersten, sodass das Gerät nur ein Schema kennen muss. Die Fallunterscheidung steht auf dem Gateway, wo Speicher und Rechenzeit reichlich vorhanden sind, nicht auf dem Knoten.
- Reduktion. Das Gateway kürzt Antworten auf das, was das Gerät braucht. Die Daten eines Spielplans schrumpften dadurch von rund 78 kB auf 11 kB.
- Zeit. Ein lokaler NTP-Dienst stellt die Uhr des Geräts. Ohne verlässliche Zeit ist keine der späteren Ableitungen möglich.
Ein Gateway ist nicht nur ein Proxy. Es ist die Stelle, an der Heterogenität stirbt.
Gemeint ist damit: Hinter dem Gateway gibt es nur noch eine einzige Datenform. Die Vielfalt der Quellen endet dort und kommt beim Gerät gar nicht erst an. Der Knoten hat einen Parser, einen Filter, einen Satz Feldnamen — und weiß nicht einmal, mit welcher Quelle er gerade spricht. Jede Fallunterscheidung, die im Gateway gelöst wird, muss nicht in einem Gerät mit 20 kB Heap gelöst werden.
Genau genommen stirbt dort allerdings nur die halbe Heterogenität: Das Gateway vereinheitlicht die Form, nicht die Entscheidung. Welcher Quelle für welchen Aspekt geglaubt wird, bleibt beim Gerät — siehe Abschnitt 5.
 Abschnitt 03Die Speicherdecke
Das Gerät hat rund 225 kB statisch belegtes DRAM. Vom Rest bleiben im Live-Betrieb typischerweise rund 20 kB frei — in einer durchgemessenen Stunde 20.328 Byte. Die Zahl, auf die es ankommt, ist aber eine andere: Der größte zusammenhängende freie Block lag zur selben Zeit bei 17.396 Byte.
3.1Warum diese beiden Zahlen auseinanderfallen
„Frei“ ist eine Summe. Sie zählt alle freien Bytes zusammen, gleichgültig, wo sie liegen. Eine Speicheranforderung braucht dagegen ein einziges Stück am Stück: Ein Puffer lässt sich nicht auf mehrere Lücken verteilen.
Im Betrieb werden laufend Blöcke belegt und wieder freigegeben. Was zurückbleibt, ist kein leerer Raum, sondern ein durchlöcherter — freie und belegte Bereiche wechseln sich ab. Das nennt man Fragmentierung:
Auf einem PC merkt man davon nichts: Dort setzt eine Speicherverwaltungseinheit in der Hardware verstreute Seiten zu einem zusammenhängenden Bereich zusammen, und die Anwendung sieht nur den fertigen Block. Ein ESP32 hat diese Einheit nicht. Was im physischen Speicher zerstückelt ist, bleibt zerstückelt. Ein freigegebener Block hilft nur dann, wenn er zufällig an einen anderen freien grenzt.
Deshalb ist „noch 20 kB frei“ auf einem solchen Gerät keine beruhigende Auskunft. Die belastbare Frage lautet: Wie groß ist das größte Stück am Stück?
Ein zweiter Effekt kommt hinzu, der noch weniger sichtbar ist. Der Arbeitsspeicher des ESP32 ist nicht ein einziger durchgehender Bereich, sondern zerfällt in mehrere Regionen — getrennte Adressbereiche, über deren Grenze hinweg kein Block wachsen kann. Was in der einen Region frei wird, nützt in der anderen nichts.
An diesem Gerät liegen die Stapelspeicher der Tasks in einer anderen Region als der große freie Block — 0x3ffe0440 gegenüber 0x3ffe4350. Ein Vorschlag, einen Task-Stack um 2 kB zu verkleinern, hätte den nutzbaren Block deshalb um kein einziges Byte vergrößert. Er hätte nur den Stack an den Rand des Überlaufs gebracht:
Wer auf so einem Gerät Speicher sucht, muss also wissen, wo er frei wird, nicht nur wie viel.
3.2Elementweises Lesen
Zurück zu den 17 kB am Stück, und damit zur Datenseite: Die Antwortdokumente der Quellen sind um ein Vielfaches größer. Die Daten eines Spielplans brachten es vor der Kürzung im Gateway auf rund 78 kB — mehr als das Vierfache dessen, was sich überhaupt am Stück belegen lässt. Auch gekürzt bleiben Dokumente übrig, die nicht in einem Stück in den Speicher passen.
Zwei Dinge heißen dabei fast gleich, deshalb vorab die Begriffe:
| Begriff | was gemeint ist |
|---|---|
| JSON-Dokument | der Text, den die Quelle über HTTP liefert. Groß, und während der Verarbeitung nur als Strom vorhanden — er wird nie als Ganzes im Gerät abgelegt |
| Ablage | die Datenstruktur im Arbeitsspeicher des ESP32, in die geparste Werte gelegt werden. Die verwendete Bibliothek nennt auch sie „Document“ — hier heißt sie Ablage, damit die beiden nicht verschwimmen |
Ein JSON-Dokument der Quellen ist im Kern ein Array — eine Liste gleichartiger Einträge. Was darin steht, hängt vom Abruf ab:
| Abruf | ein Eintrag ist … |
|---|---|
| Spieltag | eine Partie mit Stand und Torliste |
| Tabelle | eine Mannschaft mit Punkten und Tordifferenz |
| Aufstellung | ein Spieler mit Position und Rückennummer |
| Spielverlauf | ein Ereignis der laufenden Partie: Tor, Karte, Abschnittswechsel |
Der naheliegende Weg wäre, dieses Array vollständig in eine Ablage zu parsen, also ein Abbild des ganzen Dokuments im Speicher aufzubauen. Genau das geschieht nie.
Stattdessen wird immer nur ein einzelner Eintrag zugleich abgelegt — im Beispiel unten eine Partie. Ein Filter legt dabei fest, welche Felder eines Eintrags überhaupt übernommen werden; alles andere überliest der Parser, ohne dafür Speicher zu belegen:
Damit hängt der Speicherbedarf nicht mehr an der Größe des Dokuments, sondern nur noch am größten einzelnen Eintrag. Ob eine Runde drei oder einunddreißig Partien enthält, ändert am Bedarf nichts — und das ist der eigentliche Gewinn: Die Auslegung wird unabhängig von einer Zahl, über die das Gerät nicht bestimmt. Dieselbe Ablage trägt deshalb auch alle anderen Abrufarten aus der Tabelle oben, ohne dass eine davon eine eigene bekommt.
Die Ablage wird einmal angelegt und für alle Abrufe benutzt. Es gibt genau einen Abrufweg im ganzen Programm. Das ist keine Ästhetik, sondern Speicherpolitik: Zwei Abrufwege bedeuten zwei Ablagen, und die zweite ist genau die, die bei der nächsten Erweiterung nicht mehr hineinpasst.
3.3Der Einbruch, der nicht von der Anwendung kam
Monatelang zeigten die Protokolle Speichertiefs unter 1,3 kB. Die Suche lief in der Anwendung — größere Puffer, kleinere Puffer, andere Reihenfolgen. Gefunden wurde nichts, weil dort nichts war.
Die Einbrüche stammten vom WLAN-Treiber. Er legt Empfangspuffer zu je 2.308 Byte an, bis zu 32 Stück, und zwar dynamisch bei Empfangslast. Das sind im Extremfall über 70 kB, die plötzlich fehlen — und zwar genau dann, wenn gerade eine Antwort hereinkommt, also genau dann, wenn die Anwendung selbst am meisten braucht.
Die Obergrenze für diese Puffer wurde von 32 auf 6 gesenkt. Im schlimmsten Fall belegt der Treiber damit rund 14 kB statt 72 kB — knapp 60 kB weniger. Im Live-Betrieb liegt der Speicherboden seither bei 23 kB statt unter 1,3 kB, bei null fehlgeschlagenen Belegungen.
Wenn der Speicher einbricht und die Anwendung nichts erklärt, such in den Schichten darunter — im Framework und in den Treibern. Sie sind stille Großverbraucher, und ihre Puffergrößen stehen selten dort, wo man sie vermutet.
3.4Warum man vorher misst
Eine Erweiterung eines Puffers um 1 kB legte das gesamte Gerät lahm. Nicht langsamer, nicht instabil — es lief nicht mehr an. Der größte freie Block war zu dem Zeitpunkt zwölf Byte zu klein.
Seither gilt die Regel: Vor jeder Vergrößerung wird der größte freie Block nachgesehen, nicht der freie Speicher. Fragmentierung ist auf einem Gerät ohne MMU kein akademisches Thema, sondern die häufigste Absturzursache nach dem Nullzeiger.
3.5Eine TLS-Sitzung, nicht viele
Ein TLS-Handschlag kostet auf diesem Gerät mehrere Kilobyte gleichzeitig verfügbaren Speichers. Es gibt deshalb genau eine Verbindung, die wiederverwendet wird.
Die Bedingung dafür ist unscheinbar und entscheidend: Wiederverwendet wird nur, wenn die vorige Antwort restlos gelesen wurde. Bleibt auch nur ein Byte im Strom, ist die Verbindung nicht wiederverwendbar, und der nächste Abruf baut neu auf — mit vollem Speicherbedarf, meist genau dann, wenn viel los ist.
Darin steckt eine Messfalle. Wer prüfen will, ob der teure Verbindungsaufbau noch zuverlässig gelingt, löst dafür naheliegenderweise viele Abrufe kurz hintereinander aus. Genau das misst ihn aber nicht: Solange die Verbindung offen bleibt, wird sie wiederverwendet. Ein neuer Handschlag entsteht nur nach dem Start des Geräts und nachdem die Verbindung 60 Sekunden ungenutzt war.
Wer also Abruf an Abruf reiht, bekommt jedes Mal den billigen Fall — und hält ihn für den teuren. Der teure Fall braucht eine Pause, kein Gedränge.
 Abschnitt 04Adaptive Abtastung
4.1Drei Takte
| Betriebsart | Takt | wann |
|---|---|---|
| Ruhe | 1 Stunde | nichts steht an |
| Vorlauf | 1 Minute | ein Anstoß ist nah |
| Live | 20 Sekunden | eine Partie läuft |
Der Faktor zwischen Ruhe und Live ist 180. Ein fester Takt müsste sich für einen der beiden Fälle entscheiden und wäre entweder verschwenderisch oder zu langsam.
Die Entscheidung trifft eine Prüfung je Partie, die im Kern fragt: Kann sich hier überhaupt noch etwas ändern? Eine Partie, deren Endstand gelesen ist, wird nicht mehr abgefragt. Eine Partie, deren geplanter Anstoß längst vorbei ist, von der aber kein Stand vorliegt, wird ebenfalls nicht mehr abgefragt — sie fällt in einen eigenen Zustand „überfällig“.
4.2Bündeln statt einzeln fragen
Ein Pokalwettbewerb hat bis zu einunddreißig gleichzeitige Partien. Die erste Umsetzung fragte jede einzeln ab. Das ergab rund dreißig Anfragen je Runde und provozierte, was zu erwarten war: HTTP 429, Too Many Requests.
Die Korrektur war, die Runde in einer Anfrage zu holen. Damit das im Speicher bleibt, greift wieder das elementweise Lesen — die Antwort wird nie als Ganzes gehalten. Gemessen im Betrieb: 31 gebündelte Runden, rund 100 ms, null Einzelabrufe.
Ein Ratenlimit ist selten ein Serverproblem. Es ist meistens die Quittung für eine Zugriffsform, die für eine andere Größenordnung entworfen wurde — hier: für eine Handvoll gleichzeitiger Partien statt für einunddreißig.
4.3Nur holen, was sich geändert hat
Die Quelle liefert je Datensatz einen Änderungszeitstempel. Bleibt er gleich, entfällt der große Abruf vollständig. Das Gerät hält zusätzlich ein Gedächtnis über bereits besuchte Spieltage, sodass das Zurückblättern in bekannte Daten ohne jeden Netzzugriff auskommt.
 Abschnitt 05Quellenfusion
Es gibt zwei Quellen. Die naheliegende Lösung wäre, je Wettbewerb eine auszuwählen. Sie ist falsch.
Die Quellen sind nicht insgesamt unterschiedlich gut, sondern je Aspekt. Deshalb wird je Aspekt entschieden:
| Aspekt | Quelle | Grund |
|---|---|---|
| Tore, Tabelle | A | vollständiger, konsistenter |
| Anpfiff, Halbzeit, Abpfiff | B | Quelle A hat gar kein Zustandsfeld |
Das ist der Kern dessen, was in der Sensorik Fusion heißt: nicht mitteln, sondern wissen, welche Quelle worin belastbar ist — und das durch Messung, nicht durch Annahme.
5.1Was die Messung über die Quellen ergab
Diese Eigenheiten wurden im Betrieb festgestellt, nicht der Dokumentation entnommen — es gibt keine:
- Quelle A kennt keinen Zustand „läuft“. Das einzige Zustandsfeld ist „ist beendet“. Ob eine Partie begonnen hat, muss aus der Existenz von Ergebniszeilen und der Uhrzeit abgeleitet werden. Eine 0:0-Zeile beweist dabei nichts: Sie wird teils vorab angelegt.
- Bei Quelle B läuft die Toreliste dem Spielstand um rund 40 Sekunden voraus. Wer beides liest, sieht ein Tor, das im Stand noch nicht steht. Die Abhilfe ist, die Toreliste am Spielstand abzuschneiden — lieber 40 Sekunden später als 40 Sekunden falsch.
- Tore werden zurückgenommen, ohne dass das vermerkt wird. Ein Stand kann sinken. Jede Logik, die Monotonie annimmt, ist damit falsch.
- Eigentore dürfen nicht umgedreht werden. Das wurde an 686 von 686 Fällen geprüft, weil die Gegenannahme plausibel klingt und teuer wäre.
- Der Statusname schwankt, die Abschnittsnummer nicht. Wer auf Textfelder prüft, bekommt gelegentlich eine andere Schreibweise; das numerische Feld ist stabil.
5.2Verlässlichkeit ist eine Eigenschaft des Wettbewerbs, nicht des Geräts
Wie gut eine Halbzeit-Zeile geführt wird, hängt am Wettbewerb. In einem gemessenen Fall kam der Übergang zweimal, jeweils rund vierzig Sekunden bevor die andere Quelle die Pause überhaupt kannte. Für andere Wettbewerbe gibt es keine solche Messung.
Daraus folgte ein Schalter je Wettbewerb statt eines globalen. Ein globaler Schalter hätte zwei Fehler zugleich gemacht: die gute Quelle verschenkt und der schlechten geglaubt.
 Abschnitt 06Zustand statt nachgebauter Erkennung
Die erste Umsetzung ließ jede interessierte Stelle selbst erkennen, ob sich etwas geändert hatte — der Signalgeber, die Animation, die Halbzeit-Erkennung, die Anzeige. Jede merkte sich einen eigenen Vorzustand. Das führte zu den bekannten Folgen: doppelte Auslösungen, ausbleibende Auslösungen, und vier Stellen, die zu unterschiedlichen Ergebnissen kamen.
Die Umstellung war zweiteilig:
- Eine Funktion bestimmt die Phase einer Partie aus den Rohdaten. Sie ist die einzige Stelle, die Quellenfelder auswertet.
- Ein Wechsel legt ein Ereignis in eine Queue. Alle anderen lesen Ereignisse, statt sich Wechsel selbst zu bauen.
Damit feuert ein Übergang von Bauart her genau einmal. Vorher musste das jede Stelle für sich sicherstellen — und eine davon tat es nicht.
Ein Zustand ist, was gerade gilt. Ein Übergang ist der Moment, in dem er sich ändert. Angezeigt wird auf Zustände, signalisiert wird auf Übergänge.
Der Unterschied ist praktisch: Wer das Gerät mitten in einer Halbzeitpause einschaltet, soll sehen, dass Pause ist — aber keinen Pausenpfiff hören. Dass Pause ist, ist ein Zustand und gilt weiter; der Pfiff war ein Übergang und ist verklungen.
Für ein Tor gilt dasselbe, und genau hier wird die Trennung greifbar: Der Spielstand erscheint sofort — er ist Zustand, und ein 2:1 bleibt ein 2:1, gleichgültig wann man hinsieht. Signalton und Animation bleiben aus — sie gehörten zum Übergang, und der liegt zurück. Zustände werden nachgeholt, Ereignisse nicht.
 Abschnitt 07Methodik: Wiedergabe statt Warten
Der schwierigste Teil bei einem Gerät, das auf Ereignisse in der echten Welt reagiert, ist die Prüfung. Live-Verhalten lässt sich nur live beobachten — und live ist zweimal die Woche für neunzig Minuten.
Die Lösung war eine Aufzeichnung auf dem Gateway. Alle Antworten eines Spieltags werden mitgeschnitten und lassen sich später erneut abspielen. Das Gerät merkt den Unterschied nicht; es sieht dieselben Antworten in derselben Reihenfolge.
Damit ließ sich jede Änderung am Live-Verhalten prüfen, ohne auf ein Spiel zu warten — die Bündelung der Rundenabrufe ebenso wie die Zustandserkennung. In der industriellen Praxis ist das ein bekanntes Verfahren; für ein Bastelprojekt ist es der Unterschied zwischen „vermutlich richtig“ und „geprüft“.
Drei Beweisregeln, die sich im Betrieb ergaben
Diese drei Regeln sind aus Fehlschlägen entstanden und gelten inzwischen als Bedingung dafür, dass ein Befund als belegt zählt:
Nacheinander gemessen ist nicht verglichen. Misst man erst mit der alten Einstellung und danach mit der neuen, kann ein Unterschied von der Änderung kommen — oder von allem anderen, was sich inzwischen geändert hat: Netzlast, Tageszeit, Datenmenge, Temperatur. In den Zahlen sieht beides gleich aus, und man kann nicht mehr sagen, woher der Unterschied stammt. Erst wenn man im Wechsel misst — A, B, A, B —, lässt er sich der Änderung zuschreiben statt dem Zufall.
Eine passende Rechnung ist kein Beweis. Dass eine Vermutung die gemessene Zahl erklärt, bestätigt sie nicht: Meist gibt es mehrere Erklärungen, die dieselbe Zahl ergeben. Gesucht ist nicht die Rechnung, die passt, sondern die Messung, bei der die Erklärungen verschiedene Ergebnisse vorhersagen.
Eine leere Liste beweist nichts. Sie kann bedeuten, dass nichts da ist — oder dass falsch gefragt wurde. Im Protokoll sehen beide Fälle gleich aus. Bevor man aus einer Leere etwas schließt, muss man sie von einem Fehlgriff unterscheiden können.
Abschnitt 08Was schiefging
Ein Erfahrungsbericht ohne Fehlschläge ist eine Werbebroschüre. Die folgenden Fälle haben je mehrere Stunden gekostet und sind übertragbar:
| Symptom | tatsächliche Ursache |
|---|---|
| Gerät startet nach einer Änderung nicht mehr | Puffer um 1 kB vergrößert; größter freier Block war 12 Byte zu klein |
| Speichertiefs unter 1,3 kB, Anwendung unverdächtig | WLAN-Treiber legt bis zu 32 Empfangspuffer zu je 2.308 B an |
| Verbindungsfehler bei intaktem Netz | Nicht das Netz, sondern Speichermangel beim TLS-Handschlag. Der Fehlercode legt das Netz nahe und führt zuverlässig in die falsche Richtung |
| Antworten gültig, aber alle Felder leer | Der Filter war für ein ganzes Array geschrieben, gelesen wurde elementweise. Er passte damit auf nichts — und der Parser meldete Erfolg und lieferte ein sauberes Objekt, in dem alles null war. Kein Fehler, keine Ausnahme, keine leere Antwort |
| Ratenbegrenzung durch den Server | Dreißig Einzelabrufe je Runde statt einer gebündelten Anfrage |
| Halbzeit-Erkennung schlug fehl, nachdem das Gateway die Antworten kürzte | Die Kürzung entfernte genau die Zeile, auf der die Erkennung beruht |
Der letzte Fall ist der lehrreichste: Eine Optimierung auf dem Gateway — Antworten kürzen, um Speicher zu sparen — nahm dem Gerät eine Information weg, von der das Gateway nichts wusste. Wer im Gateway kürzt, braucht ein Verzeichnis dessen, was der Knoten tatsächlich liest — sonst ist die Optimierung eine Regression, die niemand ihr zuordnet.
Abschnitt 09Grenzen dieses Berichts
Damit die Zahlen richtig eingeordnet werden:
- Es ist ein Gerät, kein Feld. Aussagen über Streuung zwischen Exemplaren gibt es nicht.
- Die Quellen sind fremde Dienste ohne Zusicherungen. Was heute gemessen wurde, kann morgen anders sein; mehrere der oben genannten Eigenheiten haben sich im Beobachtungszeitraum geändert.
- Es gibt keinen Vergleich gegen Alternativen. Ob eine andere Parser-Bibliothek oder ein anderer Netzwerk-Stack besser abgeschnitten hätte, wurde nicht untersucht.
- Die Messungen stammen aus dem Protokoll des Geräts selbst. Sie sind damit so gut wie dessen Instrumentierung — und die wurde mehrfach korrigiert, weil sie Zahlen zeigte, die zueinander nicht passten.
Abschnitt 10Was übertragbar ist
Für andere vernetzte Geräte, die Zustände aus fremden Systemen abbilden:
- Der größte freie Block ist die Kennzahl, nicht der freie Speicher. Auf einem Gerät ohne Speicherverwaltung entscheidet Fragmentierung, und sie steht in keiner der üblichen Statistiken.
- Netzwerktreiber sind stille Großverbraucher. Ihre Puffergrößen gehören zur Auslegung des Geräts, nicht in die Voreinstellungen des Herstellers.
- Eine Abtastrate ist eine Entwurfsentscheidung, kein Parameter. Der Faktor zwischen Ruhe und Ereignis kann drei Größenordnungen betragen; ein fester Takt verschenkt eine davon.
- Ein Gateway ist die Stelle, an der Heterogenität stirbt. Jede Fallunterscheidung dort kostet nichts; im Knoten kostet sie Speicher, den er nicht hat.
- Wer im Gateway kürzt, braucht ein Verzeichnis dessen, was der Knoten liest. Sonst ist die Ersparnis eine Regression, die niemand einer Optimierung zuordnet.
- Zustand und Übergang sind zweierlei, und ein Übergang gehört an genau eine Stelle. Selbstgebaute Erkennung an vier Stellen ergibt vier verschiedene Wahrheiten.
- Wiedergabe schlägt Warten. Wer Ereignisse aus der echten Welt verarbeitet, braucht eine Aufzeichnung — sonst prüft er nie, sondern hofft.
Dieser Bericht beschreibt ein privates Projekt. Die Zahlen stammen aus dem laufenden Betrieb; Quelle und Methodik sind jeweils genannt. Wo nichts gemessen wurde, steht es dabei.
Die beiden Datenquellen sind bewusst nur als A und B geführt: Der Bericht handelt von der Technik, nicht von den Anbietern.
Die Kapitelbilder sind mit einem Bildgenerator erzeugt und für diese Seite zugeschnitten. Beim Verfassen des Textes war ein Sprachmodell beteiligt; Messungen, Entscheidungen und Fehlschläge stammen aus dem Betrieb des Geräts.